

遍历专题 DFS 与 BFS|算法篇
本节我们学习两种关键的基本算法思想:DFS(深度优先搜索)和BFS(广度优先搜索)。这两种算法和栈、队列有着千丝万缕的关系,如果前两节你认真学习掌握了,那么这一节对你来说相信不是问题。
# 深度优先搜索思想:不撞南墙不回头的“迷宫游戏”
30 秒速记
- DFS 沿一条分支走到底,走不通才回退;递归调用栈或显式栈都能实现。
- 图搜索必须在“入栈/进入递归”时标记
visited,否则有环图会重复访问甚至死循环。 - 时间复杂度是
O(V + E);空间最坏O(V),树高为h时递归栈通常是O(h)。 - DFS 擅长枚举路径、连通性、拓扑与回溯,不保证无权图最短路。
DFS 会沿当前分支一直向深处搜索,走不通时再回退到最近的岔路口。 它可以用递归调用栈实现,也可以自己维护显式栈,本质都是后进先出。遍历有环图时,我一般会在节点入栈或进入递归时标记 visited,避免重复访问甚至死循环。它适合路径枚举、连通性和回溯,时间为 O(V + E),但不保证找到无权图的最短路径。
回答参考:“DFS 的核心不是递归语法,而是后进先出的待办集合。我会先定义访问标记时机,再说明当前路径与已完成节点各代表什么。”
function dfs(graph, start) {
  if (start == null) return []
  const stack = [start]
  const visited = new Set([start])
  const order = []

  while (stack.length) {
    const node = stack.pop()
    order.push(node)
    const neighbors = graph.get(node) ?? []
    for (let i = neighbors.length - 1; i >= 0; i -= 1) {
      const next = neighbors[i]
      if (!visited.has(next)) {
        visited.add(next)
        stack.push(next)
      }
    }
  }
  return order
}
面试官追问
追问 1迷宫页面把 DFS 理解成“必须写递归”,代码改为数组 stack 后评审认为已经不是 DFS,你会怎样用执行现象反驳?
只要待办节点按后进先出处理,搜索就会沿一条分支持续深入,遇到无路可走再回到最近分叉点,这仍是 DFS。递归只是借用函数调用栈实现同一调度方式;显式栈更便于控制深度,但邻居压栈顺序会直接影响访问顺序。
追问 2关系图中一个节点被多个前驱指向,页面内存突然上涨;代码直到 pop() 后才写入 visited,为什么会出现大量重复项?
节点在真正弹出前仍被视为未访问,因此多个前驱都可能把它压入栈中,造成重复状态和更高的空间峰值。通常应在首次入栈时立即加入 visited,从源头阻止再次入栈;若业务需要枚举不同路径,节点级去重又可能过早剪枝,需改为路径状态。
追问 3路由依赖图可能出现环,开发只把当前节点放进 path,回退时删除,却没有全局 visited,查询为何可能反复绕圈?
当前路径集合只能阻止本轮路径内的直接成环,节点退出路径后仍可能从其他分支再次进入。若目标是普通可达性遍历,应使用全局 visited 并在入栈时标记;若目标是枚举所有简单路径,则保留路径级标记,但必须接受重复探索和更高计算成本。
追问 4同一份邻接表,递归版访问顺序是 A、B、C,改成显式栈后却变成 A、C、B,你会检查哪段代码?
应检查邻居压栈顺序,因为栈是后进先出,按邻接表正序压入会让最后一个邻居先被访问。若要复现递归中从左到右的顺序,应从邻接表末尾向前压栈;这只影响确定性的访问次序,不改变 DFS 的可达性结果。
追问 5导航页面既要找到出口,也要展示一条可回放路线;团队在“栈内容就是路径”和 parent 映射之间争论,你会选哪种?
若显式栈中的元素始终代表当前分支,命中出口时栈内容可以直接形成路线,但常见的待办栈会同时保存尚未探索的分支,并不天然等于路径。通用实现更适合在首次发现节点时记录 parent,命中后反向恢复;代价是为已发现节点额外保存映射。
20世纪90年代,小霸王学习机风靡全国。没有哪个小学生,不想拥有一台自己的小霸王学习机——我,也不例外;没有哪个小学生在拥有了小霸王学习机之后,会真的用它来搞学习——我,也不例外。在那个没有王者也没有吃鸡的年代里,小霸王里让我欲罢不能的除了魂斗罗、超级玛丽,还有它——迷宫游戏:
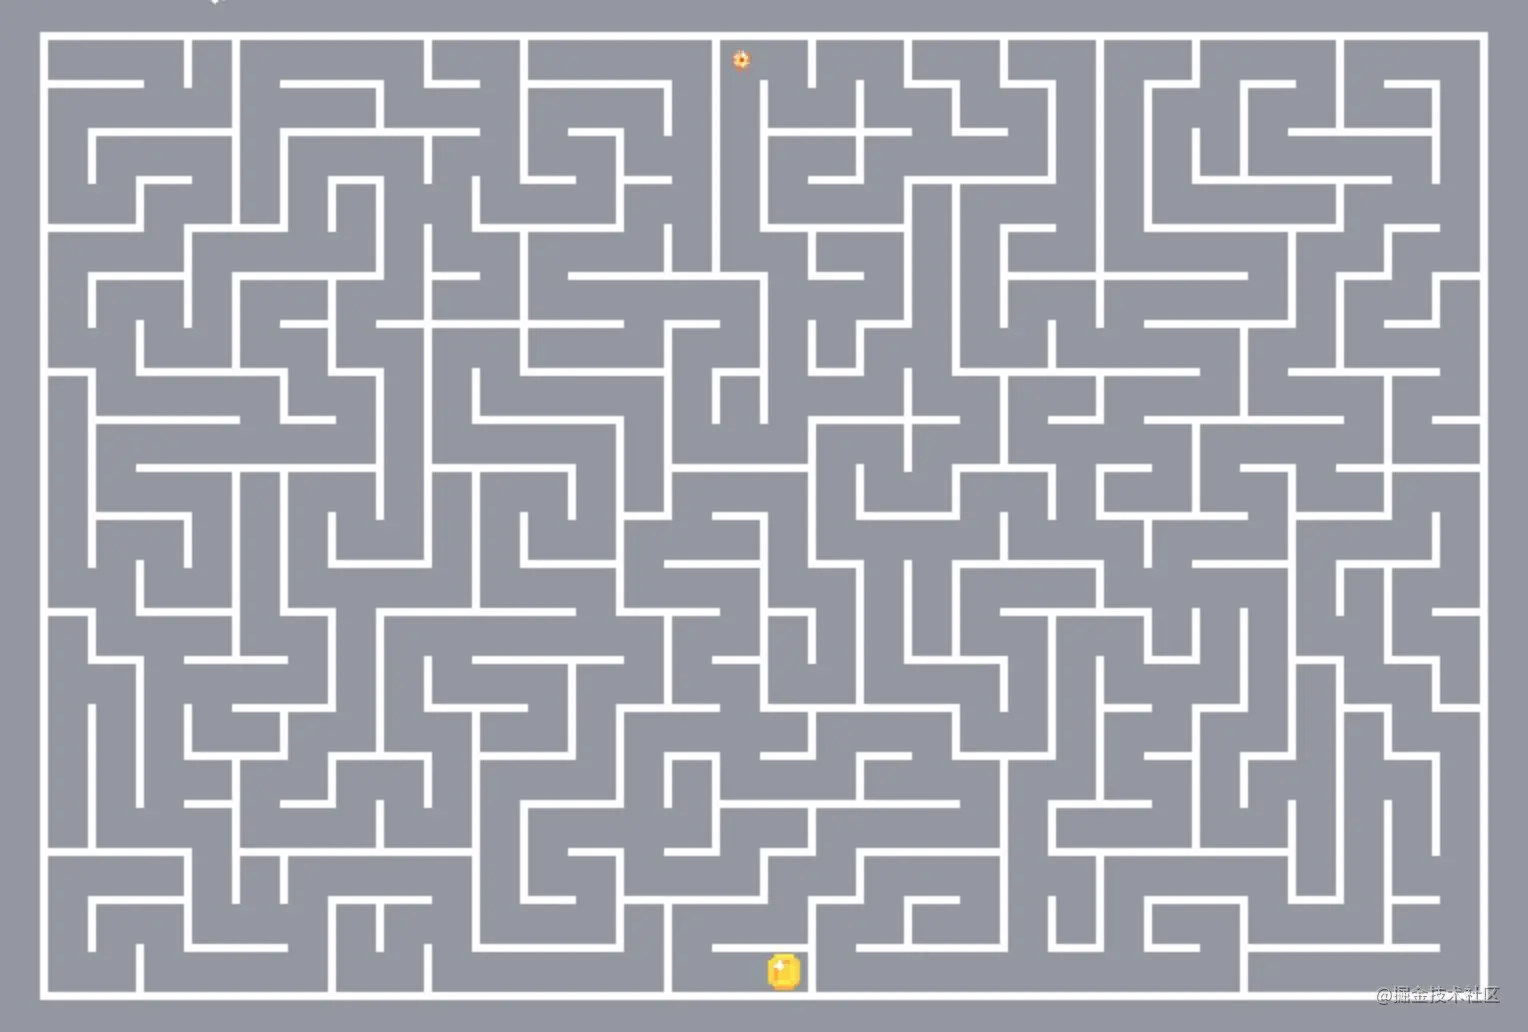
很多同学跟我说他入门算法的时候就挂在 DFS 这里,觉得太高深了,学不动。傻孩子,今天你就会知道,深度优先搜索也不过是在用编码的方式玩一场迷宫游戏。
现在把图上的小黄点想象成你自己,由于你手里没有地图、没有无人机,因此你对迷宫整体的地形一无所知。放眼望去,你眼前只有冰冷的墙壁和并不知道能不能走通的道路。如何走出一条通路?你只能尝试把每一条能走的路都走一遍——也就是所谓的“穷举法”:
- 以当前位置为起点,闷头往前走
- 在前进的过程中,难免会遇到岔路口。这个路口可能分叉出去两条、三条、四条甚至更多的道路,你只能选择其中的一条路、然后继续前进(注意,你可能会不止一次遇到岔路口;每遇到一个新的岔路口,你都需要做一次选择)。
- 你选择的这条路未必是一条通路。如果你走到最后发现此路不通,那么你就要退回到离你最近的那个分叉路口,然后尝试看其它的岔路能不能走通。如果当前的岔路口分叉出去的所有道路都走不通,那么就需要退回到当前岔路口的上一个岔路口,进一步去寻找新的路径。
按照这个思路走下去,只要迷宫是有出口的,你就一定能找到这个出口。在这个过程里,我们贯彻了“不撞南墙不回头”的原则:只要没有碰壁,就决不选择其它的道路,而是坚持向当前道路的深处挖掘——像这样将“深度”作为前进的第一要素的搜索方法,就是所谓的“深度优先搜索”。
深度优先搜索的核心思想,是试图穷举所有的完整路径。
# 深度优先搜索的本质——栈结构
30 秒速记
- DFS 把尚未探索的分支保存在调用栈或显式栈中,总是继续处理最近发现的结点
- 图遍历必须在入栈或进入递归时标记
visited,否则环会导致重复访问甚至无限循环 - 时间为
O(V + E),额外空间最坏O(V);树没有共享回边时可省 visited,但要明确前提
DFS 的本质是用栈保存尚未探索完的分支,并优先处理最近发现的节点。 递归写法依赖函数调用栈,迭代写法则显式维护栈,两者的前进和回退过程是一致的。图中可能存在环,所以节点应在入栈或进入递归时加入 visited,否则可能重复访问甚至无法结束。完整遍历的时间是 O(V + E),额外空间最坏为 O(V);只有确认是无共享回边的树时,才可以省略访问标记。
那么如何使用编码来实现深度优先搜索呢?我们继续讨论迷宫问题,这里我给大家一个抽象过后的简单迷宫结构:
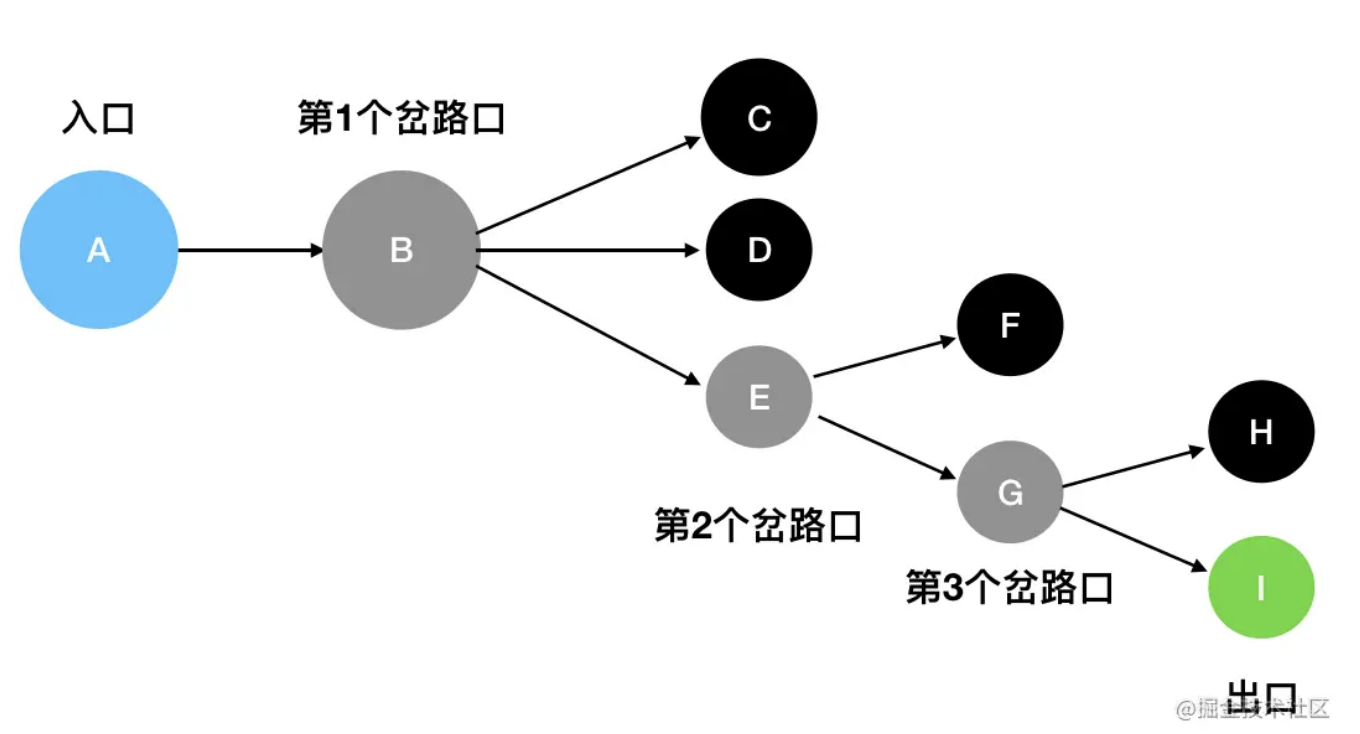
图中蓝色的是入口,灰色的是岔路口,黑色的是死胡同,绿色的是出口。
基于眼前的这个迷宫结构,我们来一步一步模拟一下深度优先搜索的具体过程:
- 从 A 出发,沿着唯一的一条道路往下走,遇到了第1个岔路口B。眼前有三个选择:C、D、E。这里我按照从上到下的顺序来走(你也可以按照其它顺序),先走C。
- 发现 C是死胡同,后退到最近的岔路口 B,尝试往D方向走。
- 发现D 是死胡同,,后退到最近的岔路口 B,尝试往E方向走。
- E 是一个岔路口,眼前有两个选择:F 和 G。按照从上到下的顺序来走,先走F。
- 发现F 是死胡同,后退到最近的岔路口 E,尝试往G方向走。
- G 是一个岔路口,眼前有两个选择:H 和 I。按照从上到下的顺序来走,先走H。
- 发现 H 是死胡同,后退到最近的岔路口 G,尝试往I方向走。
- I 就是出口,成功走出迷宫。
大家观察一下这个过程,会不会觉得这些前进、后退的操作,其实和栈结构的入栈、出栈过程非常相似呢?
现在我们把迷宫中的每一个坐标看做是栈里的一个元素,用栈来模拟这个过程:
- 从 A 出发(A入栈),经过了B(B入栈),接下来面临 C、D、E三条路。这里按照从上到下的顺序来走(你也可以选择其它顺序),先走C(C入栈)。
- 发现 C是死胡同,后退到最近的岔路口 B(C出栈),尝试往D方向走(D入栈)。
- E 是一个岔路口,眼前有两个选择:F 和 G。按照从上到下的顺序来走,先走F(F入栈)。
- 发现F 是死胡同,后退到最近的岔路口 E(F出栈),尝试往G方向走(G入栈)。
- G 是一个岔路口,眼前有两个选择:H 和 I。按照从上到下的顺序来走,先走H(H入栈)。
- 发现 H 是死胡同,后退到最近的岔路口 G(H出栈),尝试往I方向走(I入栈)。
- I 就是出口,成功走出迷宫。
此时栈里面的内容就是A、B、E、G、I,因此 A->B->E->G->I 就是走出迷宫的路径。通过深度优先搜索,我们不仅可以定位到迷宫的出口,还可以记录下相关的路径信息。
现在大家知道了深度优先搜索的过程可以转化为一系列的入栈、出栈操作。那么深度优先搜索在编码上一般会如何实现呢?这里,就需要大家回忆一下第 5 节的内容了——DFS 中,我们往往使用递归来模拟入栈、出栈的逻辑。
面试官追问
追问 1迷宫演示页把所有相邻岔路一次性压入待办栈,然后直接把整个栈渲染成当前路线,为什么画面会出现互不相连的节点?
待办栈保存的是未来要探索的候选状态,其中可能同时存在来自不同分支的节点,因此不一定构成一条连续路线。要展示当前路径,应让栈帧保存节点及下一邻居位置,或另外维护可回退的路径;把普通遍历待办栈直接当路径只在特定推进方式下成立。
追问 2协作图有大量汇聚边,代码在节点出栈时才去重,压栈数量远超节点数;你会把标记动作移到哪里?
应在节点首次入栈时就写入 visited,这样后续邻居发现同一节点时会立即跳过,避免重复进入待办集合。出栈标记虽然最终也能避免重复处理,却可能积累许多重复栈项;若状态是否重复还取决于路径,则不能只按节点标记。
追问 3产品要求迷宫分支严格按页面从上到下探索,邻接表也是这个顺序,显式栈实现为什么必须反向压入邻居?
因为栈后进先出,最后压入的邻居会最先弹出;若按从上到下正序压栈,实际探索次序会完全反过来。应从邻接表末尾向前压栈,使最上方分支最后入栈、最先处理;如果产品不关心路线稳定性,则无需为顺序增加约束。
追问 4递归迷宫在一条极深走廊上触发 Maximum call stack size exceeded,改成显式栈后应保留哪些递归帧信息?
至少要保存当前节点;若需要精确模拟“尝试一个分支、失败后继续下一个分支”,栈帧还应保存邻居列表中的下一处理位置。仅保存节点适合普通遍历,但不能自然还原完整回溯过程;显式栈绕开调用栈上限,却把状态管理责任交给实现者。
追问 5面试中候选人说 BFS 也能找到出口,为什么迷宫题仍可能选择 DFS 的栈方案?
若只要求找到任意出口或展示沿分支深入再回退的过程,DFS 与迷宫叙事和路径栈更直接,也不必承诺最短路线。若需求变为无权图中的最少步数,BFS 的分层探索更匹配目标;继续使用 DFS 即使找到出口,也不能据此证明路径最短。
# DFS 与二叉树的遍历
30 秒速记
- 二叉树先序、中序、后序本质都是 DFS,只是访问根结点的时机不同
- 树高决定递归深度;退化树可能让 JavaScript 调用栈溢出,应准备显式栈版本
- 路径题要区分共享状态与分支状态,回溯时撤销当前选择,或把路径复制给子分支
二叉树的先序、中序和后序遍历本质上都是 DFS,区别只是处理根节点的时机。 递归不断进入子树,相当于沿分支向深处走;遇到空节点返回,就是从死胡同回退。递归深度由树高决定,退化成链表时,JavaScript 可能出现调用栈溢出,这时可以改用显式栈。处理路径状态时还要分清是否共享数据:共享路径需要在回退时撤销选择,也可以为每个子分支复制一份路径。


